Flowable API
流程引擎 API 与服务
引擎 API 是与 Flowable 交互最常见的方式。主要入口是 ProcessEngine,它可以按配置一节所述的几种方式创建。通过 ProcessEngine,你可以获取包含工作流/BPM 方法的各种服务。ProcessEngine 和各服务对象都是线程安全的,因此在整个服务器期间你都可以保留对其中一个的引用。
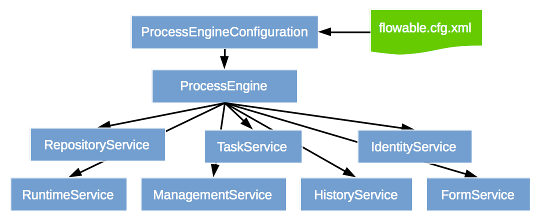
ProcessEngine processEngine = ProcessEngines.getDefaultProcessEngine();

RuntimeService runtimeService = processEngine.getRuntimeService();
RepositoryService repositoryService = processEngine.getRepositoryService();
TaskService taskService = processEngine.getTaskService();
ManagementService managementService = processEngine.getManagementService();
IdentityService identityService = processEngine.getIdentityService();
HistoryService historyService = processEngine.getHistoryService();
FormService formService = processEngine.getFormService();
DynamicBpmnService dynamicBpmnService = processEngine.getDynamicBpmnService();
ProcessEngines.getDefaultProcessEngine() 在首次被调用时会初始化并构建一个流程引擎,此后总是返回同一个流程引擎。所有流程引擎的正确创建和关闭可以通过 ProcessEngines.init() 和 ProcessEngines.destroy() 完成。
ProcessEngines 类会扫描所有 flowable.cfg.xml 和 flowable-context.xml 文件。对于所有 flowable.cfg.xml 文件,流程引擎将以典型的 Flowable 方式构建:ProcessEngineConfiguration.createProcessEngineConfigurationFromInputStream(inputStream).buildProcessEngine()。对于所有 flowable-context.xml 文件,流程引擎将以 Spring 方式构建:先创建 Spring 应用上下文,再从该应用上下文中获取流程引擎。
所有服务都是无状态的。这意味着你可以很容易地在集群中的多个节点上运行 Flowable,每个节点都连到同一个数据库,而无需担心之前的调用究竟由哪台机器执行。对任何服务的任何调用都是幂等的,无论它在哪里执行。
RepositoryService 很可能是使用 Flowable 引擎时第一个需要的服务。该服务提供用于管理和操作部署与流程定义的操作。这里不展开太多细节:流程定义是 BPMN 2.0 流程在 Java 中的对应物。它表示流程中每个步骤的结构和行为。部署是 Flowable 引擎中的打包单元。一个部署可以包含多个 BPMN 2.0 XML 文件以及任何其他资源。一个部署中包含什么由开发者决定。它可以从单个流程的 BPMN 2.0 XML 文件,到一整个流程及相关资源的包(例如,部署 'hr-processes' 可以包含与 HR 流程相关的一切)。RepositoryService 可以部署这样的包。部署一个部署意味着它被上传到引擎,其中所有流程在存入数据库之前都会被检查和解析。从那时起,系统就知道了该部署,部署中包含的任何流程现在都可以被启动。
此外,该服务还允许你:
- 查询引擎已知的部署和流程定义。
- 挂起和激活整个部署或特定的流程定义。挂起意味着不能再对它们执行任何操作,而激活则相反,重新允许操作。
- 取回各种资源,例如部署中包含的文件或引擎自动生成的流程图。
- 获取流程定义的 POJO 版本,可用于以 Java 而非 XML 内省流程。
RepositoryService 主要处理静态信息(不变化或变化不大的数据),而 RuntimeService 则正好相反。它负责启动流程定义的新流程实例。如上所述,流程定义定义了流程中不同步骤的结构和行为。流程实例就是该流程定义的一次执行。对于每个流程定义,通常会有许多实例同时运行。RuntimeService 也是用于取回和存储流程变量的服务。这些数据是特定于给定流程实例的,可以被流程中的各种构件使用(例如,排他网关经常使用流程变量来选择继续流程的路径)。Runtimeservice 还允许你查询流程实例和执行实例。执行实例是 BPMN 2.0 中 'token'(令牌)概念的表示。基本上,一个执行实例就是指向流程实例当前位置的指针。最后,每当流程实例正在等待外部触发、需要继续流程时,都会使用 RuntimeService。流程实例可以有各种等待状态,该服务包含各种操作,用于向实例发出'已收到外部触发、流程实例可以继续'的信号。
需要由系统人工用户执行的任务,是 Flowable 这类 BPM 引擎的核心。围绕任务的一切都归在 TaskService 中,例如:
- 查询分配给用户或组的任务
- 创建新的独立任务。这些是与流程实例无关的任务。
- 操作任务分配给哪个用户,或哪些用户以某种方式参与该任务。
- 认领并完成任务。认领意味着某人决定成为该任务的办理人,即该用户将完成该任务。完成意味着'做完任务的工作'。通常这就是填写某种表单。
IdentityService 相当简单。它支持组和用户的管理(创建、更新、删除、查询等)。重要的是要理解,Flowable 在运行时实际上不对用户做任何检查。例如,一个任务可以分配给任何用户,但引擎不会验证该用户是否为系统所知。这是因为 Flowable 引擎也可以与 LDAP、Active Directory 等服务配合使用。
FormService 是一个可选服务。也就是说,Flowable 完全可以在没有它的情况下愉快地使用,而不牺牲任何功能。该服务引入了开始表单和任务表单的概念。开始表单是流程实例启动前呈现给用户的表单,而任务表单是用户想要完成任务时显示的表单。Flowable 允许在 BPMN 2.0 流程定义中指定这些表单。该服务以易于使用的方式暴露这些数据。但同样,这是可选的,因为表单不必嵌入流程定义。
HistoryService 暴露 Flowable 引擎收集的所有历史数据。执行流程时,引擎可以保存大量数据(这是可配置的),例如流程实例启动时间、谁做了哪些任务、完成任务花了多久、每个流程实例走了哪条路径等等。该服务主要暴露访问这些数据的查询能力。
ManagementService 在使用 Flowable 编写自定义应用时通常不是必需的。它允许取回关于数据库表和表元数据的信息。此外,它还暴露作业(job)的查询能力和管理操作。作业在 Flowable 中用于各种用途,例如定时器、异步继续、延迟挂起/激活等等。后面会更详细地讨论这些主题。
DynamicBpmnService 可用于在无需重新部署的情况下修改流程定义的一部分。例如,你可以修改流程定义中某个用户任务的办理人定义,或修改某个服务任务的类名。
有关服务操作和引擎 API 的更详细信息,参见 javadocs。
异常策略
Flowable 中的基础异常是 org.flowable.engine.FlowableException,这是一个非受检异常。该异常随时可能被 API 抛出,但发生在特定方法中的'预期'异常会在 javadocs 中记录。例如,来自 TaskService 的一段摘录:
/**
 * Called when the task is successfully executed.
 * @param taskId the id of the task to complete, cannot be null.
 * @throws FlowableObjectNotFoundException when no task exists with the given id.
 */
 void complete(String taskId);
在上面的例子中,当传入一个不存在对应任务的 id 时,就会抛出异常。此外,由于 javadoc 明确声明 taskId 不能为 null,传入 null 时将抛出 FlowableIllegalArgumentException。
尽管我们希望避免庞大的异常体系,但以下子类会在特定情况下抛出。流程执行或 API 调用期间发生的、不符合下面可能异常的所有其他错误,都作为常规 FlowableException 抛出。
- FlowableWrongDbException:当 Flowable 引擎发现数据库模式版本与引擎版本不匹配时抛出。
- FlowableOptimisticLockingException:当数据存储中因同一数据条目的并发访问而发生乐观锁时抛出。
- FlowableClassLoadingException:当请求加载的类未找到,或加载该类时发生错误时抛出(例如 JavaDelegates、TaskListeners 等)。
- FlowableObjectNotFoundException:当请求或操作的对象不存在时抛出。
- FlowableIllegalArgumentException:表示在 Flowable API 调用中提供了非法参数、引擎配置中配置了非法值,或在流程定义中提供了非法值或使用了非法值的异常。
- FlowableTaskAlreadyClaimedException:当任务已被认领、调用 taskService.claim(...) 时抛出。
查询 API
从引擎查询数据有两种方式:查询 API 和原生查询。查询 API 允许你以流式(fluent)API 编写完全类型安全的查询。你可以向查询添加各种条件(所有条件以逻辑 AND 组合)以及恰好一种排序。以下代码展示了一个例子:
List<Task> tasks = taskService.createTaskQuery()
    .taskAssignee("kermit")
    .processVariableValueEquals("orderId", "0815")
    .orderByDueDate().asc()
    .list();
有时你需要更强大的查询,例如使用 OR 运算符的查询,或用查询 API 无法表达的限制。对于这些情况,我们有原生查询,它允许你编写自己的 SQL 查询。返回类型由你使用的 Query 对象定义,数据被映射到正确的对象(Task、ProcessInstance、Execution 等)。由于查询将在数据库上执行,你必须使用数据库中定义的表名和列名;这需要一些关于内部数据结构的知识,建议谨慎使用原生查询。表名可以通过 API 获取,以使依赖尽可能小。
List<Task> tasks = taskService.createNativeTaskQuery()
  .sql("SELECT * FROM " + managementService.getTableName(Task.class) +
      " T WHERE T.NAME_ = #{taskName}")
  .parameter("taskName", "gonzoTask")
  .list();

long count = taskService.createNativeTaskQuery()
  .sql("SELECT count(*) FROM " + managementService.getTableName(Task.class) + " T1, " +
      managementService.getTableName(VariableInstanceEntity.class) + " V1 WHERE V1.TASK_ID_ = T1.ID_")
  .count();
变量
每个流程实例都需要并使用数据来执行其组成的各个步骤。在 Flowable 中,这些数据称为变量,存储在数据库中。变量可以用于表达式(例如,在排他网关中选择正确的出站序列流)、用于调用外部服务的 Java 服务任务(例如提供输入或存储服务调用的结果)等等。
流程实例可以有变量(称为流程变量),执行实例(指向流程当前活动位置的特定指针)和用户任务也可以有变量。一个流程实例可以有任意数量的变量。每个变量存储在 ACT_RU_VARIABLE 数据库表的一行中。
所有 startProcessInstanceXXX 方法都有一个可选参数,用于在流程实例创建和启动时提供变量。例如,来自 RuntimeService 的:
ProcessInstance startProcessInstanceByKey(String processDefinitionKey, Map<String, Object> variables);
变量可以在流程执行期间添加。例如,(RuntimeService):
void setVariable(String executionId, String variableName, Object value);
void setVariableLocal(String executionId, String variableName, Object value);
void setVariables(String executionId, Map<String, ? extends Object> variables);
void setVariablesLocal(String executionId, Map<String, ? extends Object> variables);
请注意,变量可以为给定执行实例设置为local(局部)(请记住,流程实例由一棵执行实例树组成)。该变量仅在该执行实例上可见,在执行实例树的更高层不可见。如果数据不应传播到流程实例级别,或变量在流程实例的某条路径上有新值(例如使用并行路径时),这会很有用。
变量也可以取回,如下所示。请注意,TaskService 上也存在类似方法。这意味着任务与执行实例一样,可以拥有仅在任务期间'存活'的局部变量。
Map<String, Object> getVariables(String executionId);
Map<String, Object> getVariablesLocal(String executionId);
Map<String, Object> getVariables(String executionId, Collection<String> variableNames);
Map<String, Object> getVariablesLocal(String executionId, Collection<String> variableNames);
Object getVariable(String executionId, String variableName);
<T> T getVariable(String executionId, String variableName, Class<T> variableClass);
execution.getVariables();
execution.getVariables(Collection<String> variableNames);
execution.getVariable(String variableName);

execution.setVariables(Map<String, object> variables);
execution.setVariable(String variableName, Object value);
请注意,上述所有方法也都有带 local 的变体。
由于历史原因(以及向后兼容性),进行上述任何调用时,幕后都会从数据库取回所有变量。这意味着如果你有 10 个变量,但只通过 getVariable("myVariable") 取一个,幕后会把其他 9 个变量取回并缓存。这不一定是坏事,因为后续调用不会再次访问数据库。例如,当你的流程定义有三个顺序执行的服务任务(因此有一个数据库事务)时,在第一个服务任务中用一次调用取回所有变量,可能比在每个服务任务中分别取回所需变量更好。请注意,这一点对获取和设置变量都适用。
当然,当使用大量变量,或仅仅是当你想严格控制数据库查询和流量时,这种方式就不合适了。为此引入了额外的方法以更精细地控制:新增的方法带有一个可选参数,告诉引擎是否取回并缓存所有变量:
Map<String, Object> getVariables(Collection<String> variableNames, boolean fetchAllVariables);
Object getVariable(String variableName, boolean fetchAllVariables);
void setVariable(String variableName, Object value, boolean fetchAllVariables);
当参数 fetchAllVariables 使用 true 时,行为将与上述完全一致:获取或设置一个变量时,所有其他变量都会被取回并缓存。
然而,当使用 false 作为值时,将使用特定查询,不会取回或缓存其他任何变量。只有所讨论变量的值会被缓存供后续使用。
瞬态变量
瞬态变量是行为与普通变量类似、但不持久化的变量。通常,瞬态变量用于高级用例。拿不准时,就用普通流程变量。
瞬态变量遵循以下规则:
- 瞬态变量完全不存储历史。
- 与普通变量一样,瞬态变量在设置时被放到最高层父节点。这意味着当在某个执行实例上设置变量时,瞬态变量实际上存储在流程实例执行上。与普通变量一样,如果变量设置在特定执行实例或任务上,也存在该方法的 local 变体。
- 瞬态变量只能在流程定义的下一个'等待状态'之前访问。之后它们就消失了。这里的等待状态指流程实例被持久化到数据存储中的时刻。请注意,async(异步)活动在这个定义下也是一个'等待状态'!
- 瞬态变量只能通过 setTransientVariable(name, value) 设置,但调用 getVariable(name) 时也会返回瞬态变量(同时存在 getTransientVariable(name),它只检查瞬态变量)。这样做的原因是让表达式书写更简单,使用变量的现有逻辑对两种类型都生效。
- 瞬态变量会遮蔽同名的持久变量。这意味着当流程实例上同时设置了持久变量和瞬态变量、并调用 getVariable("someVariable") 时,将返回瞬态变量的值。
在大多数暴露普通变量的地方,你都可以设置和获取瞬态变量:
- 在 JavaDelegate 实现中的 DelegateExecution 上
- 在 ExecutionListener 实现中的 DelegateExecution 上,以及在 TaskListener 实现中的 DelegateTask 上
- 在脚本任务中通过 execution 对象
- 通过运行时服务启动流程实例时
- 完成任务时
- 调用 runtimeService.trigger 方法时
这些方法遵循普通流程变量的命名约定:
void setTransientVariable(String variableName, Object variableValue);
void setTransientVariableLocal(String variableName, Object variableValue);
void setTransientVariables(Map<String, Object> transientVariables);
void setTransientVariablesLocal(Map<String, Object> transientVariables);

Object getTransientVariable(String variableName);
Object getTransientVariableLocal(String variableName);

Map<String, Object> getTransientVariables();
Map<String, Object> getTransientVariablesLocal();

void removeTransientVariable(String variableName);
void removeTransientVariableLocal(String variableName);
下面的 BPMN 图展示了一个典型示例:
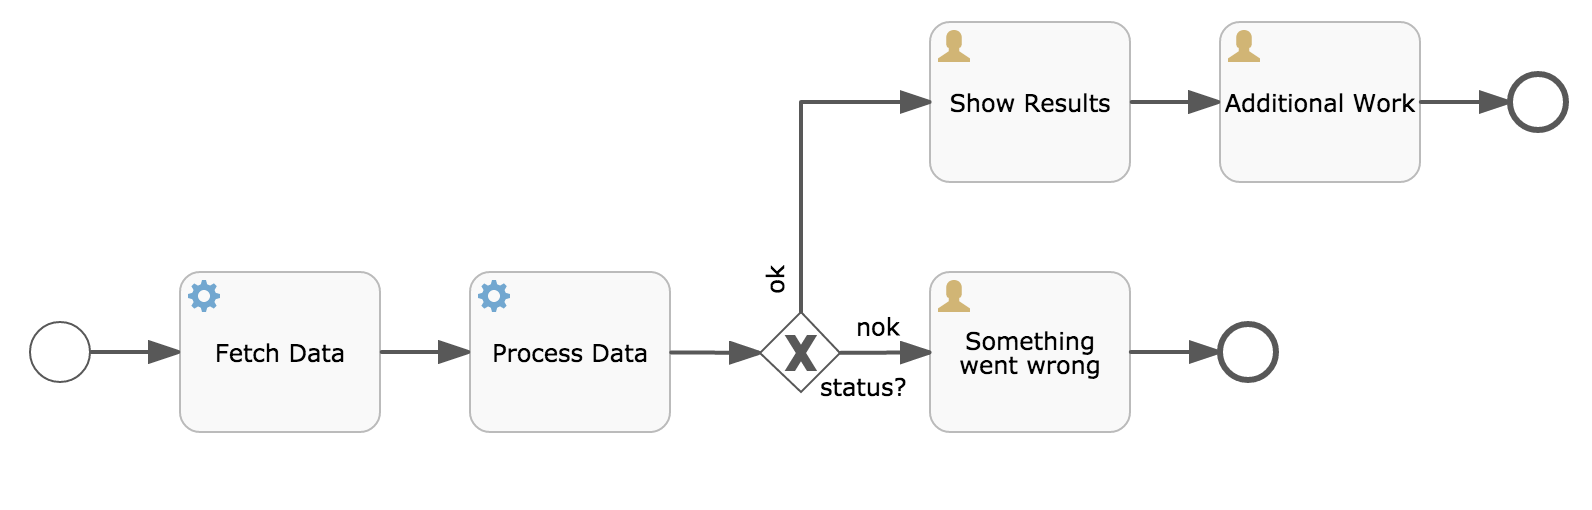
假设 'Fetch Data' 服务任务调用某个远程服务(例如使用 REST)。再假设启动流程实例时需要提供一些配置参数。此外,这些配置参数对历史审计目的并不重要,因此我们把它们作为瞬态变量传入:
ProcessInstance processInstance = runtimeService.createProcessInstanceBuilder()
       .processDefinitionKey("someKey")
       .transientVariable("configParam01", "A")
       .transientVariable("configParam02", "B")
       .transientVariable("configParam03", "C")
       .start();
请注意,瞬态变量在到达用户任务并持久化到数据库之前一直可用。例如,在 'Additional Work' 用户任务中它们就不再可用了。还要注意,如果 'Fetch Data' 是异步的,那一步之后它们也不再可用。
'Fetch Data'(简化版)可以是这样的:
public static class FetchDataServiceTask implements JavaDelegate {
  public void execute(DelegateExecution execution) {
    String configParam01 = (String) execution.getVariable(configParam01);
    // ...

    RestResponse restResponse = executeRestCall();
    execution.setTransientVariable("response", restResponse.getBody());
    execution.setTransientVariable("status", restResponse.getStatus());
  }
}
'Process Data' 会获取 response 瞬态变量,解析它,并把相关数据存入我们稍后需要用到的真正流程变量中。
离开排他网关的序列流上的条件,并不关心使用的是持久变量还是瞬态变量(本例中是 status 瞬态变量):
<conditionExpression xsi:type="tFormalExpression">${status == 200}</conditionExpression>
表达式
Flowable 使用 UEL 进行表达式解析。UEL 代表统一表达式语言(Unified Expression Language),是 EE6 规范的一部分(详见 EE6 规范)。
- 值表达式:解析为一个值。默认情况下,所有流程变量都可以使用。此外,所有 spring-bean(如果使用 Spring)也可以在表达式中使用。一些例子:
${myVar}
${myBean.myProperty}
- 方法表达式:调用一个带或不带参数的方法。**调用无参方法时,务必在方法名后加空括号(这样可以把该表达式与值表达式区分开)。**传入的参数可以是字面量值,也可以是会被自行解析的表达式。例如:
${printer.print()}
${myBean.addNewOrder('orderName')}
${myBean.doSomething(myVar, execution)}
请注意,这些表达式支持解析基本类型(包括比较)、bean、列表、数组和 map。
除了所有流程变量之外,还有几个默认可用的对象可以在表达式中使用:
- execution:DelegateExecution 持有关于当前执行的附加信息。
- task:DelegateTask 持有关于当前 Task 的附加信息。注意:仅在任务监听器求值的表达式中有效。
- authenticatedUserId:当前已认证用户的 id。如果没有用户被认证,该变量不可用。
- variableContainer:当前表达式正在为其解析的 VariableContainer。
更具体的用法和示例,参见 Spring 中的表达式、Java 服务任务、执行监听器、任务监听器或条件序列流。
表达式函数
[实验性] 表达式函数在 6.4.0 版本中加入。
为了让流程变量的使用更方便,variables 命名空间下提供了一组开箱即用的函数。
- variables:get(varName):取回一个变量的值。与在表达式中直接写变量名的主要区别是,使用该函数时变量不存在不会抛异常。例如 ${myVariable == "hello"} 在 myVariable 不存在时会抛异常,而 ${var:get(myVariable) == 'hello'} 则能正常工作。
- variables:getOrDefault(varName, defaultValue):类似于 get,但可以提供一个默认值,在变量未设置或值为 null 时返回该默认值。
- variables:exists(varName):如果变量具有非 null 值,返回 true。
- variables:isEmpty(varName)(别名 :empty):检查变量值是否为空。根据变量类型,行为如下:
-   For String variables, the variable is deemed empty if it’s the empty string.

-   For java.util.Collection variables, *true* is returned if the collection has no elements.

-   For ArrayNode variables, *true* is returned if there are no elements

-   In case the variable is *null*, *true* is always returned
- variables:isNotEmpty(varName)(别名 :notEmpty):isEmpty 的反向操作。
- variables:equals(varName, value)(别名 :eq):检查变量是否等于给定值。这是一个简写函数,否则表达式要写成 ${execution.getVariable("varName") != null && execution.getVariable("varName") == value}。
- 如果变量值为 null,返回 false(与 null 比较的情况除外)。
- variables:notEquals(varName, value)(别名 :ne):equals 的反向比较。
- variables:contains(varName, value1, value2, …):检查所提供的所有值是否都包含在变量中。根据变量类型,行为如下:
-   For String variables, the passed values are used as substrings that need to be part of the variable

-   For java.util.Collection variables, all the passed values need to be an element of the collection (regular *contains* semantics).

-   For ArrayNode variables: supports checking if the arraynode contains a JsonNode for the types that are supported as variable type

-   When the variable value is null, false is returned in all cases. When the variable value is not null, and the instance type is not one of the types above, false will be returned.
- variables:containsAny(varName, value1, value2, …):类似于 contains 函数,但只要任意(而非全部)传入的值包含在变量中就返回 true。
- variables:base64(varName):将 Binary 或 String 变量转换为 Base64 字符串
- 比较器函数:
-   **variables:lowerThan(varName, value)** (alias *:lessThan* or *:lt*) : shorthand for *${execution.getVariable("varName") != null && execution.getVariable("varName") < value}*

-   **variables:lowerThanOrEquals(varName, value)** (alias *:lessThanOrEquals* or *:lte*) : similar, but now for *< =*

-   **variables:greaterThan(varName, value)** (alias *:gt*) : similar, but now for *>*

-   **variables:greaterThanOrEquals(varName, value)** (alias *:gte*) : similar, but now for *> =*
variables 命名空间别名为 vars 或 var。因此 variables:get(varName) 等价于写 vars:get(varName) 或 var:get(varName)。请注意,变量名不需要加引号:var:get(varName) 等价于 var:get(\'varName') 或 var:get("varName")。
还要注意,上面的函数都不需要把 execution 传入函数(不使用函数时才需要)。引擎会在调用函数时注入适当的变量作用域。这也意味着,在 CMMN case 定义中写表达式时,这些函数可以用完全相同的方式使用。
此外,还可以注册可在表达式中使用的自定义函数。更多信息参见 org.flowable.common.engine.api.delegate.FlowableFunctionDelegate 接口。
单元测试
业务流程是软件项目不可分割的一部分,它们应该像测试普通应用逻辑一样被测试:用单元测试。由于 Flowable 是一个可嵌入的 Java 引擎,为业务流程编写单元测试就像编写普通单元测试一样简单。
Flowable 支持 JUnit Jupiter 风格的单元测试。
在 JUnit Jupiter 风格中,需要使用 org.flowable.engine.test.FlowableTest 注解,或手动注册 org.flowable.engine.test.FlowableExtension。
FlowableTest 注解只是一个元注解,它会完成 FlowableExtension 的注册(即 @ExtendWith(FlowableExtension.class))。
这会使 ProcessEngine 和各服务作为参数传入测试和生命周期方法(@BeforeAll、@BeforeEach、@AfterEach、@AfterAll)。
每个测试之前,processEngine 默认用 classpath 上的 flowable.cfg.xml 资源初始化。
要指定不同的配置文件,需要使用 org.flowable.engine.test.ConfigurationResource 注解(见第二个例子)。
当配置资源相同时,流程引擎会在多个单元测试之间静态缓存。
通过使用 FlowableExtension,你可以用 org.flowable.engine.test.Deployment 标注测试方法。
当测试方法标注了 @Deployment 时,每个测试之前都会部署 Deployment#resources 中定义的 bpmn 文件。
如果没有定义资源,将部署一个与测试类同包下、形式为 testClassName.testMethod.bpmn20.xml 的资源文件。
测试结束时,部署将被删除,包括所有相关的流程实例、任务等等。
更多信息参见 Deployment 类。
综合考虑以上所有内容,一个 JUnit Jupiter 测试如下所示:
使用默认资源的 JUnit Jupiter 测试。
@FlowableTest
class MyBusinessProcessTest {

  private ProcessEngine processEngine;
  private RuntimeService runtimeService;
  private TaskService taskService;

  @BeforeEach
  void setUp(ProcessEngine processEngine) {
    this.processEngine = processEngine;
    this.runtimeService = processEngine.getRuntimeService();
    this.taskService = processEngine.getTaskService();
  }

  @Test
  @Deployment
  void testSimpleProcess() {
    runtimeService.startProcessInstanceByKey("simpleProcess");

    Task task = taskService.createTaskQuery().singleResult();
    assertEquals("My Task", task.getName());

    taskService.complete(task.getId());
    assertEquals(0, runtimeService.createProcessInstanceQuery().count());
  }
}

With JUnit Jupiter you can also inject the id of the deployment (with +org.flowable.engine.test.DeploymentId+_) into your test and lifecycle methods.
使用自定义资源文件的 JUnit Jupiter 测试。
@FlowableTest
@ConfigurationResource("flowable.custom.cfg.xml")
class MyBusinessProcessTest {

  private ProcessEngine processEngine;
  private RuntimeService runtimeService;
  private TaskService taskService;

  @BeforeEach
  void setUp(ProcessEngine processEngine) {
    this.processEngine = processEngine;
    this.runtimeService = processEngine.getRuntimeService();
    this.taskService = processEngine.getTaskService();
  }

  @Test
  @Deployment
  void testSimpleProcess() {
    runtimeService.startProcessInstanceByKey("simpleProcess");

    Task task = taskService.createTaskQuery().singleResult();
    assertEquals("My Task", task.getName());

    taskService.complete(task.getId());
    assertEquals(0, runtimeService.createProcessInstanceQuery().count());
  }
}
调试单元测试
当为单元测试使用内存 H2 数据库时,以下说明让你可以在调试会话期间轻松查看 Flowable 数据库中的数据。这里的截图是在 Eclipse 中截取的,但该机制对其他 IDE 应该类似。
假设我们在单元测试的某处放了一个断点(在 Eclipse 中是双击代码旁边的左边框):
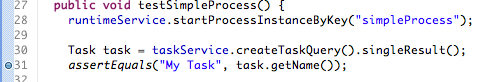
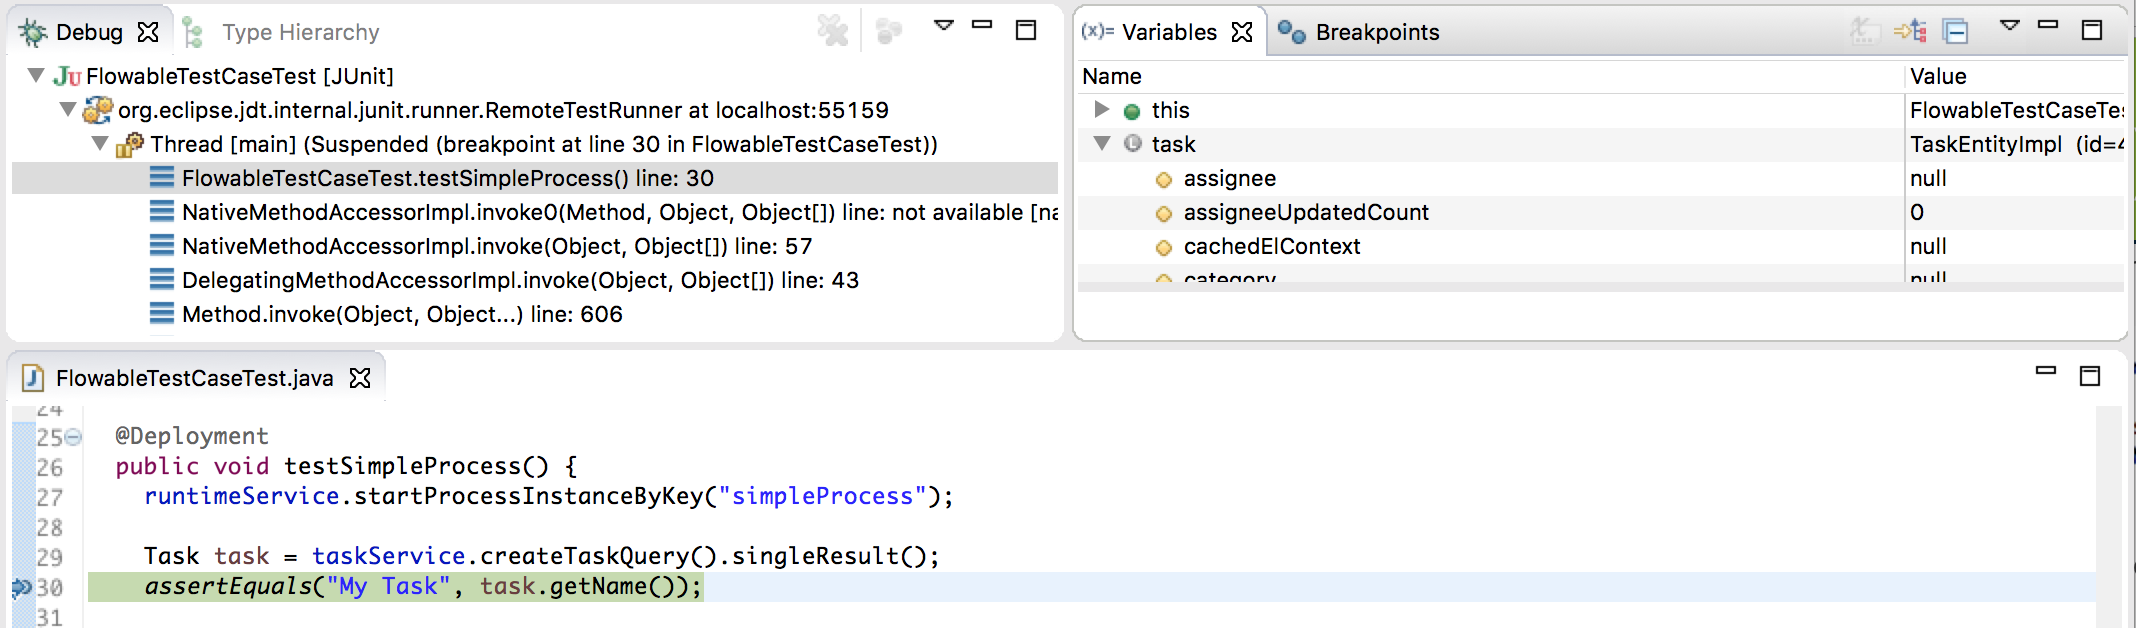
如果现在以调试模式运行单元测试(在测试类上右键,选择 'Run as',然后选 'JUnit test'),测试执行会在断点处停下,此时我们可以在右上面板中查看测试的变量,如所示。
要查看 Flowable 数据,打开 'Display' 窗口(如果没有该窗口,打开 Window→Show View→Other 并选择 Display),然后输入(有代码补全)org.h2.tools.Server.createWebServer("-web").start()
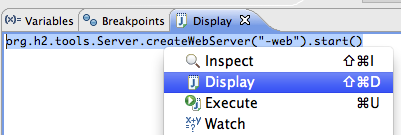
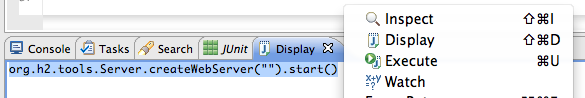
选中你刚输入的那一行并右键。现在选择 'Display'(或执行快捷键代替右键)
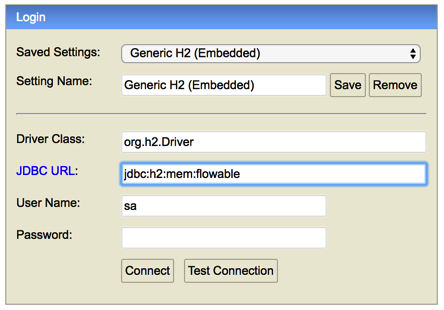
现在打开浏览器并访问 http://localhost:8082,填写到内存数据库的 JDBC URL(默认为 jdbc:h2:mem:flowable),然后点击连接按钮。
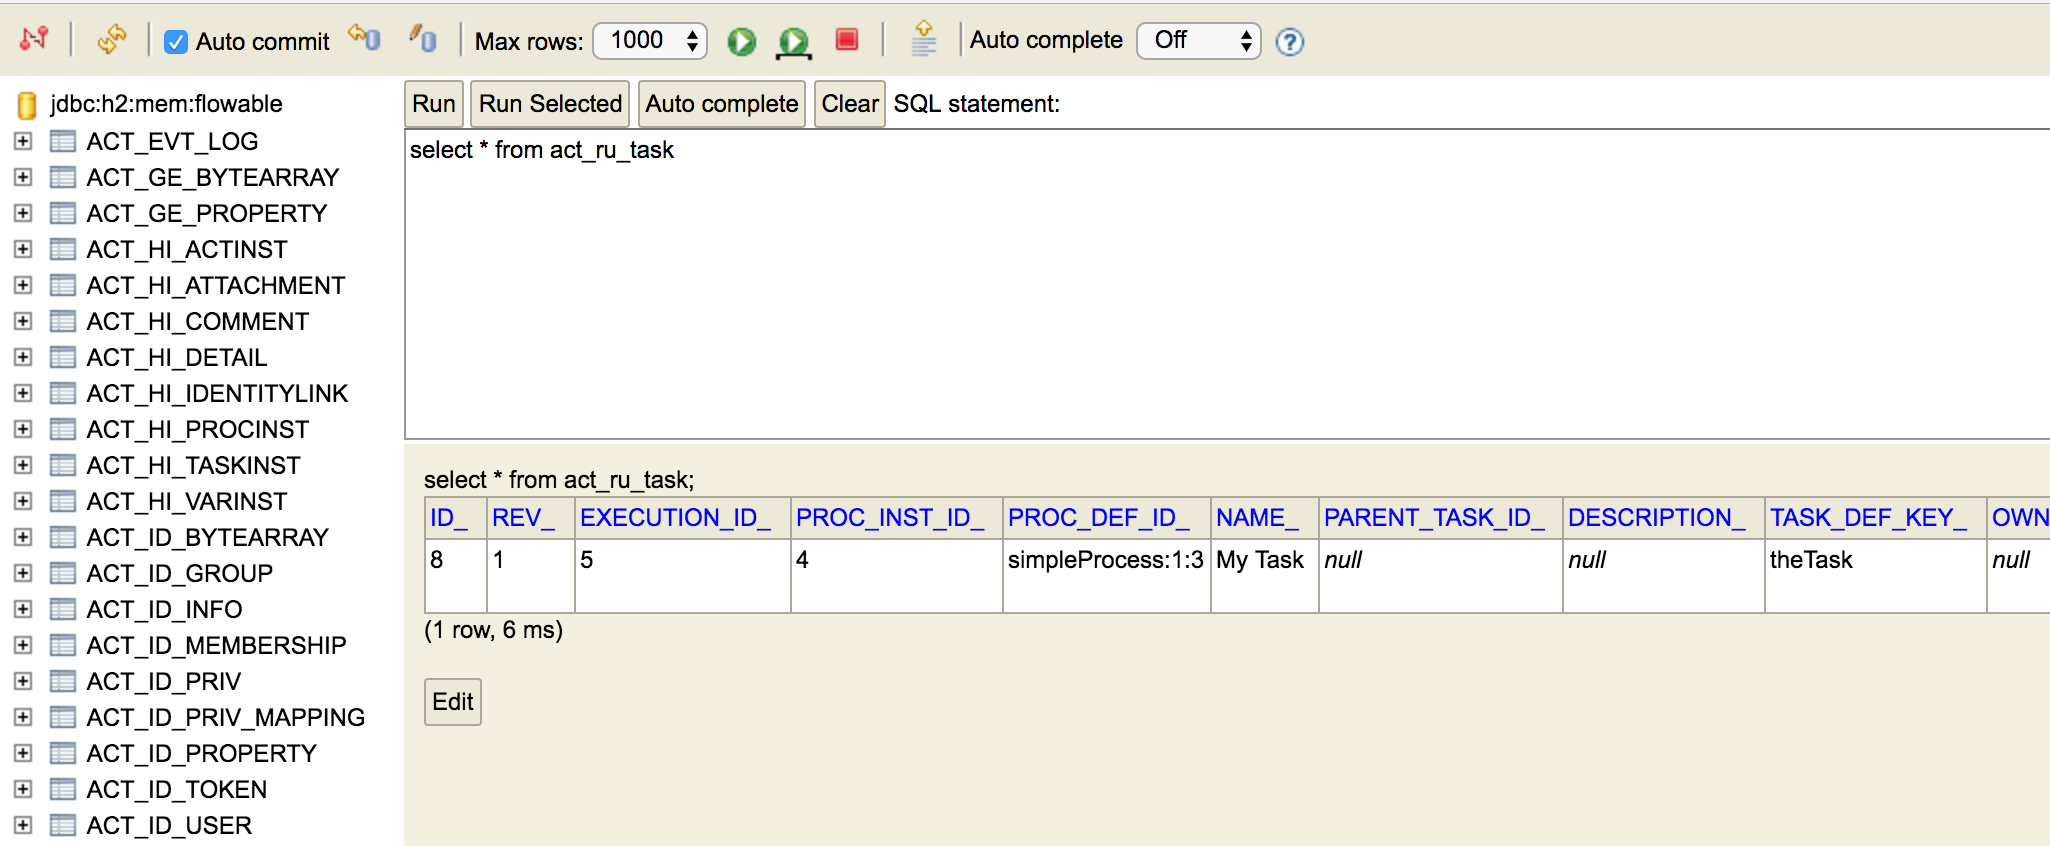
现在你可以看到 Flowable 数据,并用它来理解你的单元测试为什么以某种方式执行流程。
Web 应用中的流程引擎
ProcessEngine 是一个线程安全类,可以轻松地在多个线程之间共享。在 Web 应用中,这意味着可以在容器启动时创建一次流程引擎,并在容器关闭时关闭该引擎。
以下代码片段展示了如何在普通 Servlet 环境中编写一个简单的 ServletContextListener 来初始化和销毁流程引擎:
public class ProcessEnginesServletContextListener implements ServletContextListener {

  public void contextInitialized(ServletContextEvent servletContextEvent) {
    ProcessEngines.init();
  }

  public void contextDestroyed(ServletContextEvent servletContextEvent) {
    ProcessEngines.destroy();
  }

}
contextInitialized 方法会委托给 ProcessEngines.init()。它会在 classpath 上查找 flowable.cfg.xml 资源文件,并为给定配置创建一个 ProcessEngine(例如,多个带有配置文件的 JAR)。如果 classpath 上有多个这样的资源文件,请确保它们都有不同的名字。当需要流程引擎时,可以通过以下方式获取:
ProcessEngines.getDefaultProcessEngine()
或
ProcessEngines.getProcessEngine("myName");
当然,也可以使用任何创建流程引擎的变体,如配置一节所述。
上下文监听器的 contextDestroyed 方法委托给 ProcessEngines.destroy()。这会正确关闭所有已初始化的流程引擎。